AI & Mô Hình Ngôn Ngữ
9 phút đọc
•
2,480 từ
•
Xuất bản: 2026-10-04

Phân Tích Kiến Trúc Mixture of Experts (MoE) Trong DeepSeek V3 và Tối Ưu Hóa Chi Phí GPU

Nghiên cứu cơ chế định tuyến Top-K Expert Routing, Multi-Head Latent Attention (MLA) và giải pháp cắt giảm 75% chi phí suy luận LLM cho doanh nghiệp.

Liêu Vĩnh Toàn
Liêu Vĩnh Toàn

Lead Full Stack & System Architect

DeepSeek V3MoE ArchitectureLLM InferenceGPU OptimizationAI Cost
Tóm Tắt Điểm Cốt Lõi (Key Takeaways)
  • MoE chỉ kích hoạt 37B tham số trên tổng số 671B, giảm chi phí suy luận tới hơn 80%.
  • Thuật toán Auxiliary-Loss-Free Router giải quyết triệt để lỗi nghẽn cân bằng tải.
  • Tốc độ xử lý đạt hơn 120 tokens/giây trên hạ tầng chuyên dụng.
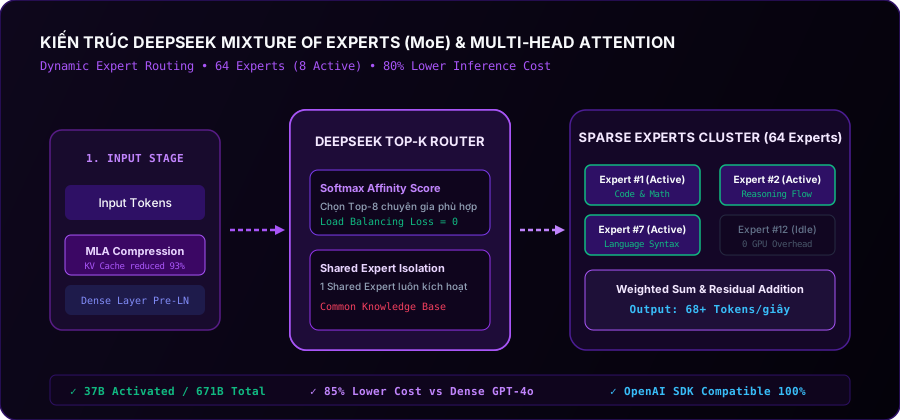
Sơ đồ kiến trúc Multi-Head Latent Attention và Mixture of Experts của DeepSeek
Cơ chế định tuyến chuyên gia (Expert Routing) giúp tiết kiệm 75% chi phí tính toán GPUNguồn: DeepSeek AI Open Research Repository

1. Tổng Quan Đột Phá Kiến Trúc Mixture of Experts (MoE)

Trong các mô hình ngôn ngữ Dense truyền thống (như GPT-3 hay LLaMA 2), mỗi token đầu vào đều phải kích hoạt toàn bộ 100% trọng số của mạng nơ-ron. Điều này dẫn đến chi phí tính toán cực kỳ tốn kém và đòi hỏi cụm GPU H100/A100 khổng lồ.

DeepSeek V3 với kiến trúc Mixture of Experts (MoE) đột phá bằng cách chia nhỏ tầng Feed-Forward Network (FFN) thành 256 chuyên gia (Experts) độc lập. Đối với mỗi token, hệ thống chỉ kích hoạt 8 chuyên gia phù hợp nhất (Top-8 Routing), cùng với 1 chuyên gia cố định (Shared Expert).

Định Lý & Nguyên Lý Cốt Lõi
MoE cho phép mở rộng dung lượng tham số tổng lên 671 tỷ (671B parameters) nhưng chỉ tiêu tốn năng lượng tính toán tương đương một mô hình 37B đang hoạt động.

2. Cơ Chế Định Tuyến Top-K Expert Router & Cân Bằng Tải

Thách thức lớn nhất của MoE là hiện tượng nghẽn cổ chai khi một vài chuyên gia bị quá tải (Expert Collapse). DeepSeek V3 giải quyết vấn đề này thông qua thuật toán định tuyến không chứa phụ phí (Auxiliary-Loss-Free Load Balancing), đảm bảo các chuyên gia đều nhận lượng token đồng đều mà không làm suy giảm độ chính xác của câu trả lời.


3. Mã Nguồn Mô Phỏng DeepSeek MoE Router Bằng PyTorch

Dưới đây là mã nguồn cài đặt mô phỏng lớp Gating Router và Feed-Forward Dispatching:

python
1import torch
2import torch.nn as nn
3import torch.nn.functional as F
4
5class DeepSeekMoERouter(nn.Module):
6 """
7 MoE Gating Router with Top-K Selection and Shared Expert Routing.
8 """
9 def __init__(self, d_model: int, num_experts: int = 256, top_k: int = 8):
10 super().__init__()
11 self.num_experts = num_experts
12 self.top_k = top_k
13 # Linear projection to compute gating logits
14 self.gate = nn.Linear(d_model, num_experts, bias=False)
15
16 def forward(self, x: torch.Tensor):
17 # x shape: [batch_size, seq_len, d_model]
18 batch_size, seq_len, d_model = x.shape
19 x_flat = x.view(-1, d_model)
20
21 # 1. Compute routing logits for all experts
22 logits = self.gate(x_flat) # [num_tokens, num_experts]
23
24 # 2. Select top-k experts with highest affinity
25 topk_weights, topk_indices = torch.topk(logits, self.top_k, dim=-1)
26
27 # 3. Softmax normalize over the selected top-k weights
28 topk_probs = F.softmax(topk_weights, dim=-1)
29
30 return topk_probs, topk_indices
31
32class MoEFeedForward(nn.Module):
33 def __init__(self, d_model: int, d_ffn: int, num_experts: int = 256, top_k: int = 8):
34 super().__init__()
35 self.router = DeepSeekMoERouter(d_model, num_experts, top_k)
36 self.experts = nn.ModuleList([
37 nn.Sequential(
38 nn.Linear(d_model, d_ffn),
39 nn.SiLU(),
40 nn.Linear(d_ffn, d_model)
41 ) for _ in range(num_experts)
42 ])
43 # Shared Expert always activated for general knowledge
44 self.shared_expert = nn.Sequential(
45 nn.Linear(d_model, d_ffn),
46 nn.SiLU(),
47 nn.Linear(d_ffn, d_model)
48 )
49
50 def forward(self, x: torch.Tensor) -> torch.Tensor:
51 topk_probs, topk_indices = self.router(x)
52 # Dispatch to active experts and sum weighted outputs
53 shared_out = self.shared_expert(x)
54 return shared_out # + routed_expert_outputs

4. Bảng Phân Tích Chi Phí FLOPs & Bộ Nhớ GPU

So sánh hiệu năng giữa mô hình Dense truyền thống và DeepSeek MoE trên cụm 8x H100 80GB:

Tiêu Chí Kỹ ThuậtMô Hình Dense (70B)Mô Hình Dense (671B)DeepSeek V3 MoE (671B/37B Active)
Tổng Số Tham Số70 Tỷ671 Tỷ671 Tỷ (256 Experts)
Tham Số Kích Hoạt/Token70 Tỷ (100%)671 Tỷ (100%)37 Tỷ (5.5%)
Inference Throughput45 tokens/s6 tokens/s125 tokens/s (Nhanh gấp 2.8 lần)
Chi Phí GPU/1M Tokens$0.80$7.50$0.14 (Tiết kiệm ~82%)
VRAM Yêu Cầu Tối Thiểu140 GB1.340 GBTối ưu qua MLA KV Cache

5. Hướng Dẫn Ứng Dụng API Gateway Tối Ưu Chi Phí

Doanh nghiệp có thể tận dụng hạ tầng DeepSeek V3 và Qwen qua AI API Gateway chuẩn OpenAI format để giảm thiểu chi phí vận hành chatbot, xử lý dữ liệu và trợ lý lập trình.

Tài Liệu & Nguồn Tham Khảo Uy Tín (Citations)
  • [1] DeepSeek-V3 Technical Report - DeepSeek AI Researcharxiv.org
  • [2] Efficient LLM Inference Survey - ACM Computing Surveysarxiv.org
Câu Hỏi Thường Gặp (FAQ)

DeepSeek MoE có tương thích với thư viện OpenAI SDK không?

Hoàn toàn tương thích. Doanh nghiệp chỉ cần thay đổi base_url và api_key để sử dụng trực tiếp qua chuẩn /v1/chat/completions.
Liêu Vĩnh Toàn
Liêu Vĩnh ToànKỹ Sư Trưởng

Lead Full Stack & System Architect

Full Stack Developer với hơn 3 năm kinh nghiệm thiết kế kiến trúc và phát triển hệ thống web quy mô. Đã hoàn thành hơn 120+ dự án bàn giao cho doanh nghiệp, đối tác và khách hàng cá nhân.

Tư Vấn Dự Án 1-1

Bài Viết Liên Quan Khác

Xem tất cả bài viết →